AMD Ryzen™ AI Embedded X100 シリーズ プロセッサー搭載 COM-HPC Client Size C モジュール
ハイパフォーマンスの CPU と GPU、NPU アーキテクチャーを統合することにより、エッジAI およびフィジカルAI のパフォーマンスを最大化
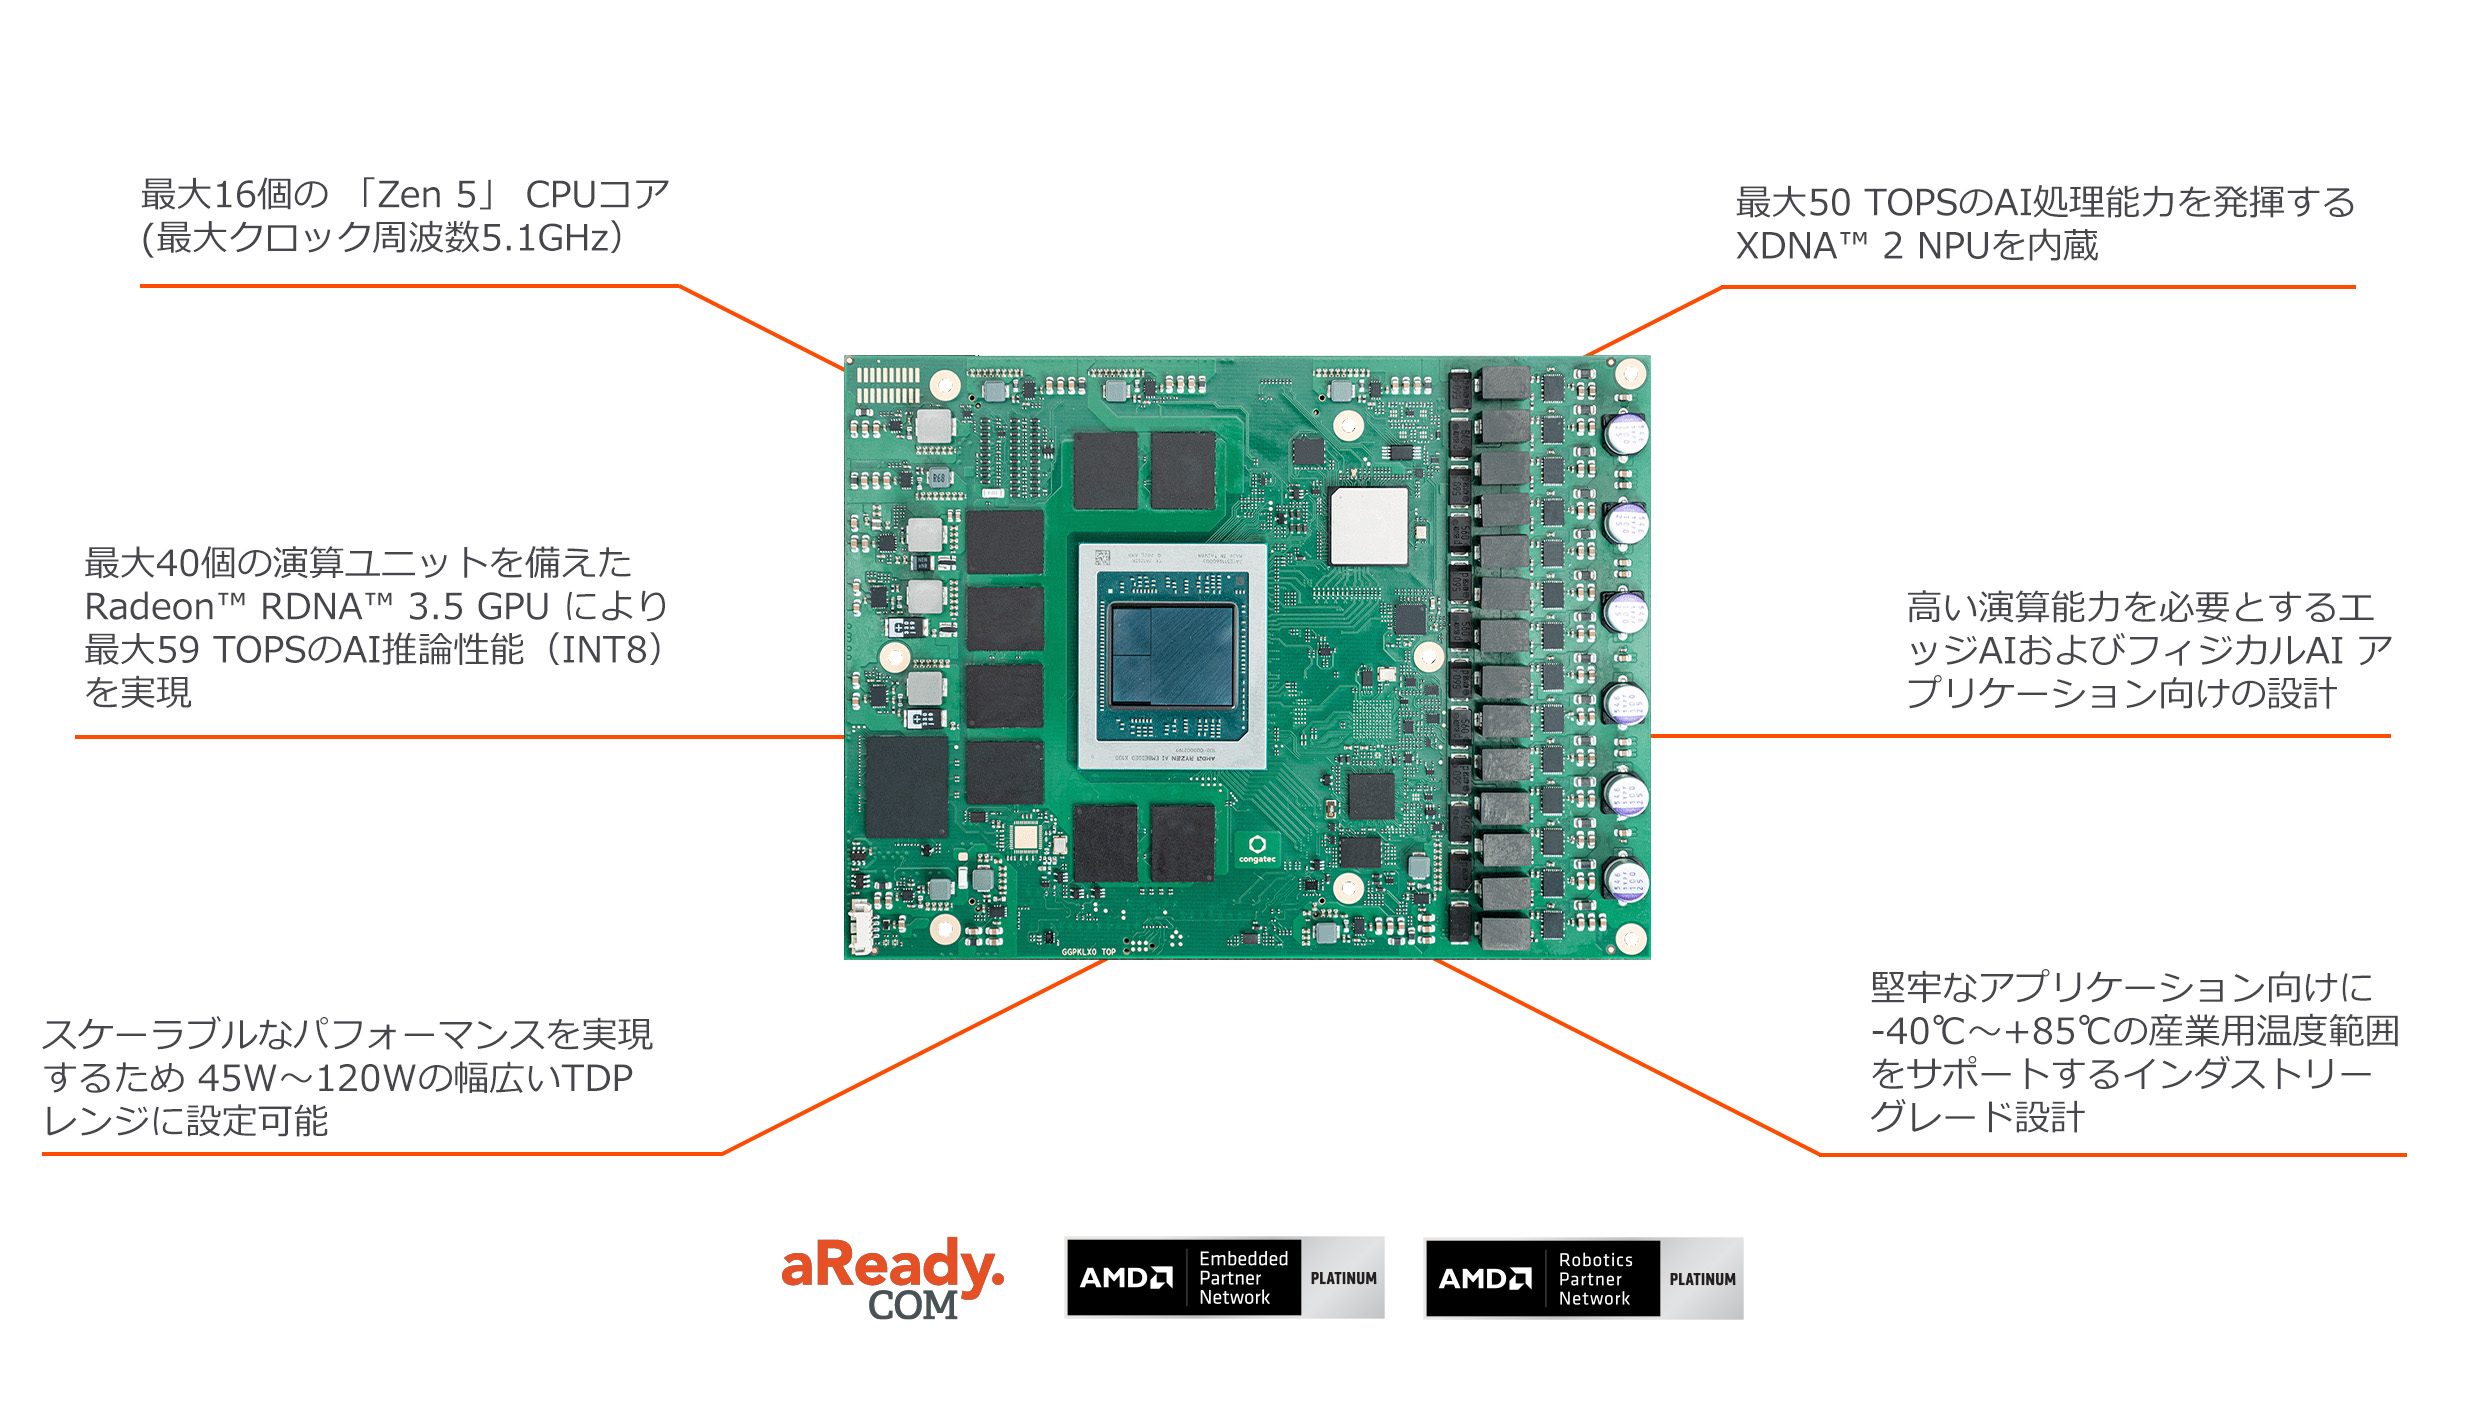
AMD Ryzen™ AI Embedded X100 シリーズ プロセッサーは、スケーラブルな組込みおよびエッジ コンピューティングにおける新たなパフォーマンスクラスを確立します。 最大16個のAMD 「Zen 5」 CPUコアと内蔵の Radeon™ RDNA™ 3.5 iGPU、そして最大50 TOPSの AIアクセラレーションを実現する専用のXDNA™ 2 NPUを、高い演算密度を誇るシステム・オン・チップ(SoC)に統合しています。 高度にインテグレートされた AIおよび FP32の演算性能により、多くのアプリケーションにおいて、外付けの AIアクセラレーター カードが不要になります。
エッジにおけるフィジカルAI のためのスケーラブルなパフォーマンス
AMD Ryzen™ AI Embedded X100 シリーズ プロセッサーは、AMD Kria™ AI SOM ポートフォリオの一部で、最新のフィジカルAI アプリケーションのパフォーマンス要件増大に対応するために特別に設計されています。 このプロセッサーはハイパフォーマンスの SoC にパワフルな CPU と GPU、NPU リソースを統合しており、エッジにおいて直接、決定論的なAIパフォーマンスを実現します。 その結果、外付けのグラフィックス カードや追加のAIハードウェア アクセラレーター、あるいはクラウド処理が不要になります。
新しい AMD Ryzen™ AI Embedded X100 シリーズは、最大16個のAMD 「Zen 5」 CPUコアに加え、最大59 TOPSの AI推論性能と最大29.7 TFLOPSの FP32演算性能を発揮する内蔵の AMD Radeon™ RDNA™ 3.5 GPU を搭載しています。 さらに、最大50 TOPSのAIパフォーマンスを提供する専用の AMD XDNA™ 2 NPU を組み合わせることで、幅広いAIワークロードに対応することができる、スケーラビリティの高いプラットフォームを実現しています。 このプロセッサーは、ロボティクスやインダストリアル オートメーション、メディカル テクノロジー、自律型商用車、スマートインフラなど、要求の厳しいフィジカルAI アプリケーションに特に適しています。
4nm プロセス技術を採用した AMDの先進的な 「Zen 5」 アーキテクチャーをベースとするこの SoCは、リアルタイム制御やセンサーフュージョン、意思決定といった、時間的制約の厳しいシーケンシャル ワークロードにおいて、極めて高いCPUパフォーマンスを発揮します。 内蔵の RDNA™ 3.5 GPU は、協働ロボットや自律走行車における画像の前処理や認識・物体検出、SLAM(自己位置推定と環境地図作成)、さらには大規模言語モデル(LLM)のローカル実行など、高度な並列処理を要するワークロードに最適です。 また、XDNA™ 2 NPU は、物体検出や音声処理、画像分類、異常検知といった常時稼働が必要な AIアプリケーション向けに最適化された高効率なAIアクセラレーターとして、このアーキテクチャーを補完します。
生成AIアプリケーションのための重要なアドバンテージの一つは、ユニファイド メモリー アーキテクチャーです。 CPU と GPUが同一の高速メモリープールを共有することで、アプリケーションに応じて柔軟に GPUにメモリーを割り当てることが可能になります。 最大128GBの LPDDR5x メモリーのうち、最大96GB を GPUのワークロードにを割り当てられるため、専用メモリーを搭載した外付けのグラフィックス カードを必要とせずに、ローカルで大規模なLLMを実行することができます。
スケーラブルなハイパフォーマンス フィジカルAI システム向け
45Wから120Wという幅広いTDP設定が可能なこの新しい SoCは、低消費電力のエッジアプリケーションから、高度な演算処理を要するフィジカルAI プラットフォームに至るまで、多種多様なパフォーマンスや冷却要件に応じた柔軟な組込みコンピューティングの最適化を実現します。 さらに、スケーラブルな COMアーキテクチャーにより、異なるパフォーマンスレベルのモジュール間でもハードウェアの基本設計を維持することができ、開発者にとって大きなメリットとなります。
AMD Ryzen™ AI Embedded X100 シリーズ プロセッサーが実現するハイレベルのパフォーマンスにより、多くのアプリケーションにおいて、外付けのグラフィックスや専用AIアクセラレーター カードが不要になります。 同時に、システムの複雑さや消費電力、冷却要件、およびBOM(部品表)コストを低減することができます。 また、重要な構成部品の数が減ることで、アプリケーション全体の信頼性と堅牢性も向上します。
ファクト、機能、利点
| ファクト | 機能 | 利点 |
|---|---|---|
| ヘテロジニアス ハイパフォーマンス アーキテクチャー | 最大16個のAMD 「Zen 5」 CPUコア、AMD Radeon™ RDNA™ 3.5 GPU、およびAMD XDNA™ 2 NPUを単一のSoCに統合 | リアルタイム制御やAI推論、および高度な並列データ処理を単一のプラットフォームに統合し、外付けのグラフィックス カードや AIアクセラレーターを不要にします。 |
| パワフルな Zen 5 CPU コア | 最大16個の CPUコア(最大クロック周波数5.1 GHz) | リアルタイム制御やセンサーフュージョン、意思決定、通信といったワークロードに対し、優れたシングルコアおよびマルチコア性能を発揮します。 |
| 内蔵 RDNA™ 3.5 GPU (iGPU) | 最大59 TOPSの AI推論(INT8)および最大29.7 TFLOPSの FP32演算性能 | 高度な並列処理やLLMのローカル実行に対応するハイパフォーマンス汎用GPU と、負荷の高いゲーミングやAV、産業用マルチディスプレイ アプリケーション向けに没入感のあるグラフィックスを提供する最大4つの独立したディスプレイを統合しています。 |
| XDNA™ 2 NPU | 最大50 TOPSのAI処理性能 | 低消費電力でのAI推論を可能にし、優れたエネルギー効率で、ロボティクスやマシンビジョン、自律走行車、インテリジェント医療機器といったフィジカルAI アプリケーションを加速させます。 |
| ユニファイド メモリー アーキテクチャー | CPU と GPU、NPUで共有アクセス可能な最大128GBのLPDDR5x-8533 メモリー。 そのうち最大96GB を内蔵GPU に割り当て可能。 | CPU と GPU、NPU間での極めて効率的なデータ共有を可能にし、データ転送のレイテンシを最小限に抑えるとともに、メモリを多用する AI や GPGPU ワークロードのパフォーマンスを大幅に向上させます。 また、GPUに割り当てられた大容量メモリーにより、専用のAIアクセラレーターを必要とせずに、大規模なLLM やマルチモーダルAIモデルをローカルで実行することも可能です。 |
| インダストリーグレードの堅牢性 | -40℃~+85℃ の産業用温度範囲、直付けメモリー、および長期供給 | 過酷な産業、輸送、および屋外環境下での信頼性の高い動作を実現するよう設計されており、熱に対する耐性の向上や平均故障間隔(MTBF)の延長により、メンテナンスの必要性や総所有コスト(TCO)を低減します。 また、長期的な供給体制により、システム全体の寿命をさらに延ばします。 |
| プログラム可能なパワー コンフィグレーション | ベースTDPは55Wで、45~120Wの範囲でTDPレンジを設定可能 | 共通のハードウェア基盤をもつ複数の製品で、熱設計を簡素化しつつ、異なるパフォーマンスレベルをサポートします。 |
| 豊富なI/O | 最大24レーンのPCIe Gen4 | 多数のPCIeレーンを備えているため、多数のペリフェラル デバイスを必要とする、I/Oを多用するアプリケーションに最適です。 産業用イーサネット インターフェースやフィールドバス アダプター、無線通信モジュール、その他レーン数の少ないデバイスを容易にインテグレーションすることができます。 その他のインターフェースには、2つの 2.5GbE、最大4つの USB 3.2 Gen2、最大8つの USB 2.0、最大2つの SATA 6Gb/s、2つの I²C、2つの UART、12本の GPIO、1つの SMBus、1つの GPSPIがあります。 |
代表的なアプリケーション分野

フィジカルAI
AMD Ryzen™ AI Embedded X100 シリーズは、フィジカルAI アプリケーションにおける認識、意思決定、およびアクチュエーションを加速させます。 CPUコアがセンサーフュージョンとアクチュエーターのリアルタイム制御を担い、GPGPU が画像処理をおこない、NPUがAI推論を効率的かつ低遅延で実行します。

自律型商用車
スマート農業や物流、林業などで使用される自律型商用車は、車載環境での決定論的なAI推論やセンサーフュージョン、および高い演算性能の恩恵を受けます。 産業用温度範囲に対応しているため、極めて過酷な環境下でも信頼性の高い動作が保証されます。

インダストリアル オートメーション
マシンビジョンシステムや自動品質検査、光学式文字認識(OCR)、予兆保全といったアプリケーションでは、膨大な量のデータを最小限のレイテンシで処理することが求められます。 ヘテロジニアス プロセッサー アーキテクチャーは、単一のコンピューティング プラットフォーム上で、画像の前処理やAI推論、リアルタイム制御を高速化します。

メディカル テクノロジー
パワフルな GPU および NPUアクセラレーションにより、超音波診断装置や内視鏡、その他の画像診断システムにおける医療画像データのローカル処理が可能になります。 AI支援による診断をデバイス上で直接実行できるため、診療現場(ポイント・オブ・ケア)における医療従事者のリアルタイムな意思決定を支援します。

ロボティクス
CPU、GPU、NPUを組み合わせることにより、画像処理やセンサーフュージョン、モーション計画が高速化されます。 これにより、協働ロボット(コボット)や自律走行搬送ロボット(AMR)、その他 Industry 5.0 における数多くのロボティクス プラットフォームにおいて、高精度かつリアルタイムな意思決定が可能になります。

スマートインフラストラクチャー
ローカル AI 処理は、インテリジェントなトラフィック監視から重要なインフラストラクチャーでのビデオ分析まで、クラウド インフラストラクチャーに依存せず、レスポンスタイムを高速化すると同時に、データ セキュリティを強化し、信頼性の高い運用を実現します。
コンガテックのコンピューター・オン・モジュールをご覧ください
AMD Ryzen™ AI Embedded X100 シリーズ プロセッサー搭載
conga-HPC/cRX1
- AMD Zen 5 CPUコア
- AMD Radeon RDNA 3.5グラフィックス
- AMD XDNA 2 NPU
- TDP範囲:45W~120W
- オンボードPCIeスイッチ(オプション)
FAQs
AMD Ryzen AI Embedded X100 シリーズを使用することで、外付けのAIアクセラレーター カードを不要にすることができますか?
多くのアプリケーションにおいて、可能です。 AMD Ryzen AI Embedded X100 シリーズの内蔵 AIおよびFP32演算性能は、幅広いユースケースにおいて、外付けのグラフィックスや AIアクセラレーター カードを不要にするのに十分な性能です。 これにより、システムの複雑さや消費電力、熱管理の負荷、およびBOM(部品表)コストを低減することができます。
フィジカルAI アプリケーションにおいて、CPU や GPU、NPU はどのように演算タスクを分担するのでしょうか?
これら3つの演算エンジンは、それぞれ明確に定義されたタスクを担います。 CPUコアは、リアルタイム制御やセンサーフュージョン、意思決定といった、時間的制約が厳しくシーケンシャルなワークロードを管理します。 内蔵GPUは、画像の前処理や認識、物体検出、SLAM(自己位置推定と環境地図作成)などの高度に並列化可能なタスクを高速化します。 NPUは、物体認識や音声認識、異常検知といった、常時稼働が求められる効率的なAIワークロードを担います。
X100 シリーズは、どのようなアプリケーションに最適ですか?
X100 シリーズ プロセッサーは、ロボティクスや自律型作業車両(スマート農業、物流、林業)、インダストリアル オートメーション(マシンビジョン、品質管理、予知保全)、メディカルテクノロジー(画像診断システム、AI支援診断)、さらには交通監視や映像解析といったスマートインフラなど、幅広いフィジカルAI アプリケーションに対応しています。
ローカルでのLLM実行のために、GPUにはどれだけのシステムメモリーを割り当てることができますか?
ユニファイド メモリー アーキテクチャーの採用により、CPU と GPU は同一の高速メモリープールを共有しています。 最大128GBのLPDDR5x-8533メモリーのうち、GPUには最大96GBを割り当てることが可能です。 これは、専用メモリーを搭載した外付けの GPU を必要とせずに、大規模なLLMをローカルで実行するのに十分な容量です。
AMD Ryzen AI Embedded X100 シリーズを搭載したモジュールが、フィジカルAIに特に適しているのはなぜでしょうか。
このモジュールは、認識やインテリジェンス、アクチュエーションに必要な演算リソースを単一のプラットフォームに集約しています。 CPU と GPU、NPUを統合したアーキテクチャーにより、多様なワークロードをエッジで直接処理できるため、クラウドへの継続的なデータ転送が不要になります。
このモジュールは、過酷な産業環境や屋外環境での動作に適していますか?
はい。 このモジュールは -40℃~+85℃ の産業用温度範囲に対応し、耐衝撃、耐振動の直付けメモリーを採用しているほか長期供給も可能で、これらは、車載や産業用、および屋外用途における重要な要件です。
このモジュールはどのようなTDPレンジに対応していて、それが熱設計やシステム アーキテクチャーにどのような影響を与えるのでしょうか?
このモジュールのベースTDPは55Wですが、45W~120W の範囲で設定が可能です。 これにより、消費電力を最適化したエッジシステムから、高度な演算処理を必要とするフィジカルAI プラットフォームに至るまで、同一のハードウェア プラットフォームでさまざまなパフォーマンス クラスに柔軟に対応することができます。
ペリフェラルの接続に利用可能な PCIeレーンの数と追加インターフェースにはどのようなものがありますか?
拡張用として最大24レーンのPCIe Gen4が利用可能で、多数のペリフェラルを接続するI/Oを多用するアプリケーションに最適です。 その他のインターフェースには、2つの 2.5GbE、最大4つの USB 3.2 Gen 2、最大8つの USB 2.0、最大2つの SATA 6Gb/s、2つの I²C、2つの UART、12本の GPIO、1つの SMBus、1つの GPSPIがあります。
どのようなオペレーティングシステムがサポートされていますか? また、あらかじめコンフィグレーション済みのソフトウェアソリューションは利用可能ですか?
サポートされているオペレーティングシステムには、Microsoft Windows 11、Windows 11 IoT Enterprise、Linux があります。 アプリケーションレディの 「aReady.COM」 として、ctrlX OS や Ubuntu Pro、KontronOSといった、ライセンスが付随してコンフィグレーション済みのオペレーティングシステムを搭載したモジュールも提供しています。